淘宝闪购 Harness 工程实践
# Harness 工程实践
AI 编码要真正进入研发流程,需要解决三个问题:AI 有没有足够的项目上下文、执行过程是否可控可恢复、产物是否经过可信验证。Harness 就是为这三个问题设计的研发执行框架。
# 一、为什么需要 Harness
直接把 AI 接进研发流程会遇到三个障碍:
- 上下文缺失:模型不了解项目的模块结构、编码规范和踩坑记录,生成的代码容易偏离项目约定;
- 过程失控:任务拆解、人工确认、失败重试没有统一编排,AI 执行到哪一步、卡在哪里说不清楚;
- 验证不可信:AI 写完代码后自己检查自己,缺乏独立的确定性验证和 CR。
Harness 的整体方案是把这三种能力分开交给不同角色:
- CLI 管确定性的工程动作:参数校验、进程调用、状态记录、验证命令;
- Skills 组织 AI 工作方法:描述任务执行策略和 Agent 行为;
- Qoder CLI 承担 Agent 执行;
- 知识库提供项目上下文;
- 遥测记录执行过程。
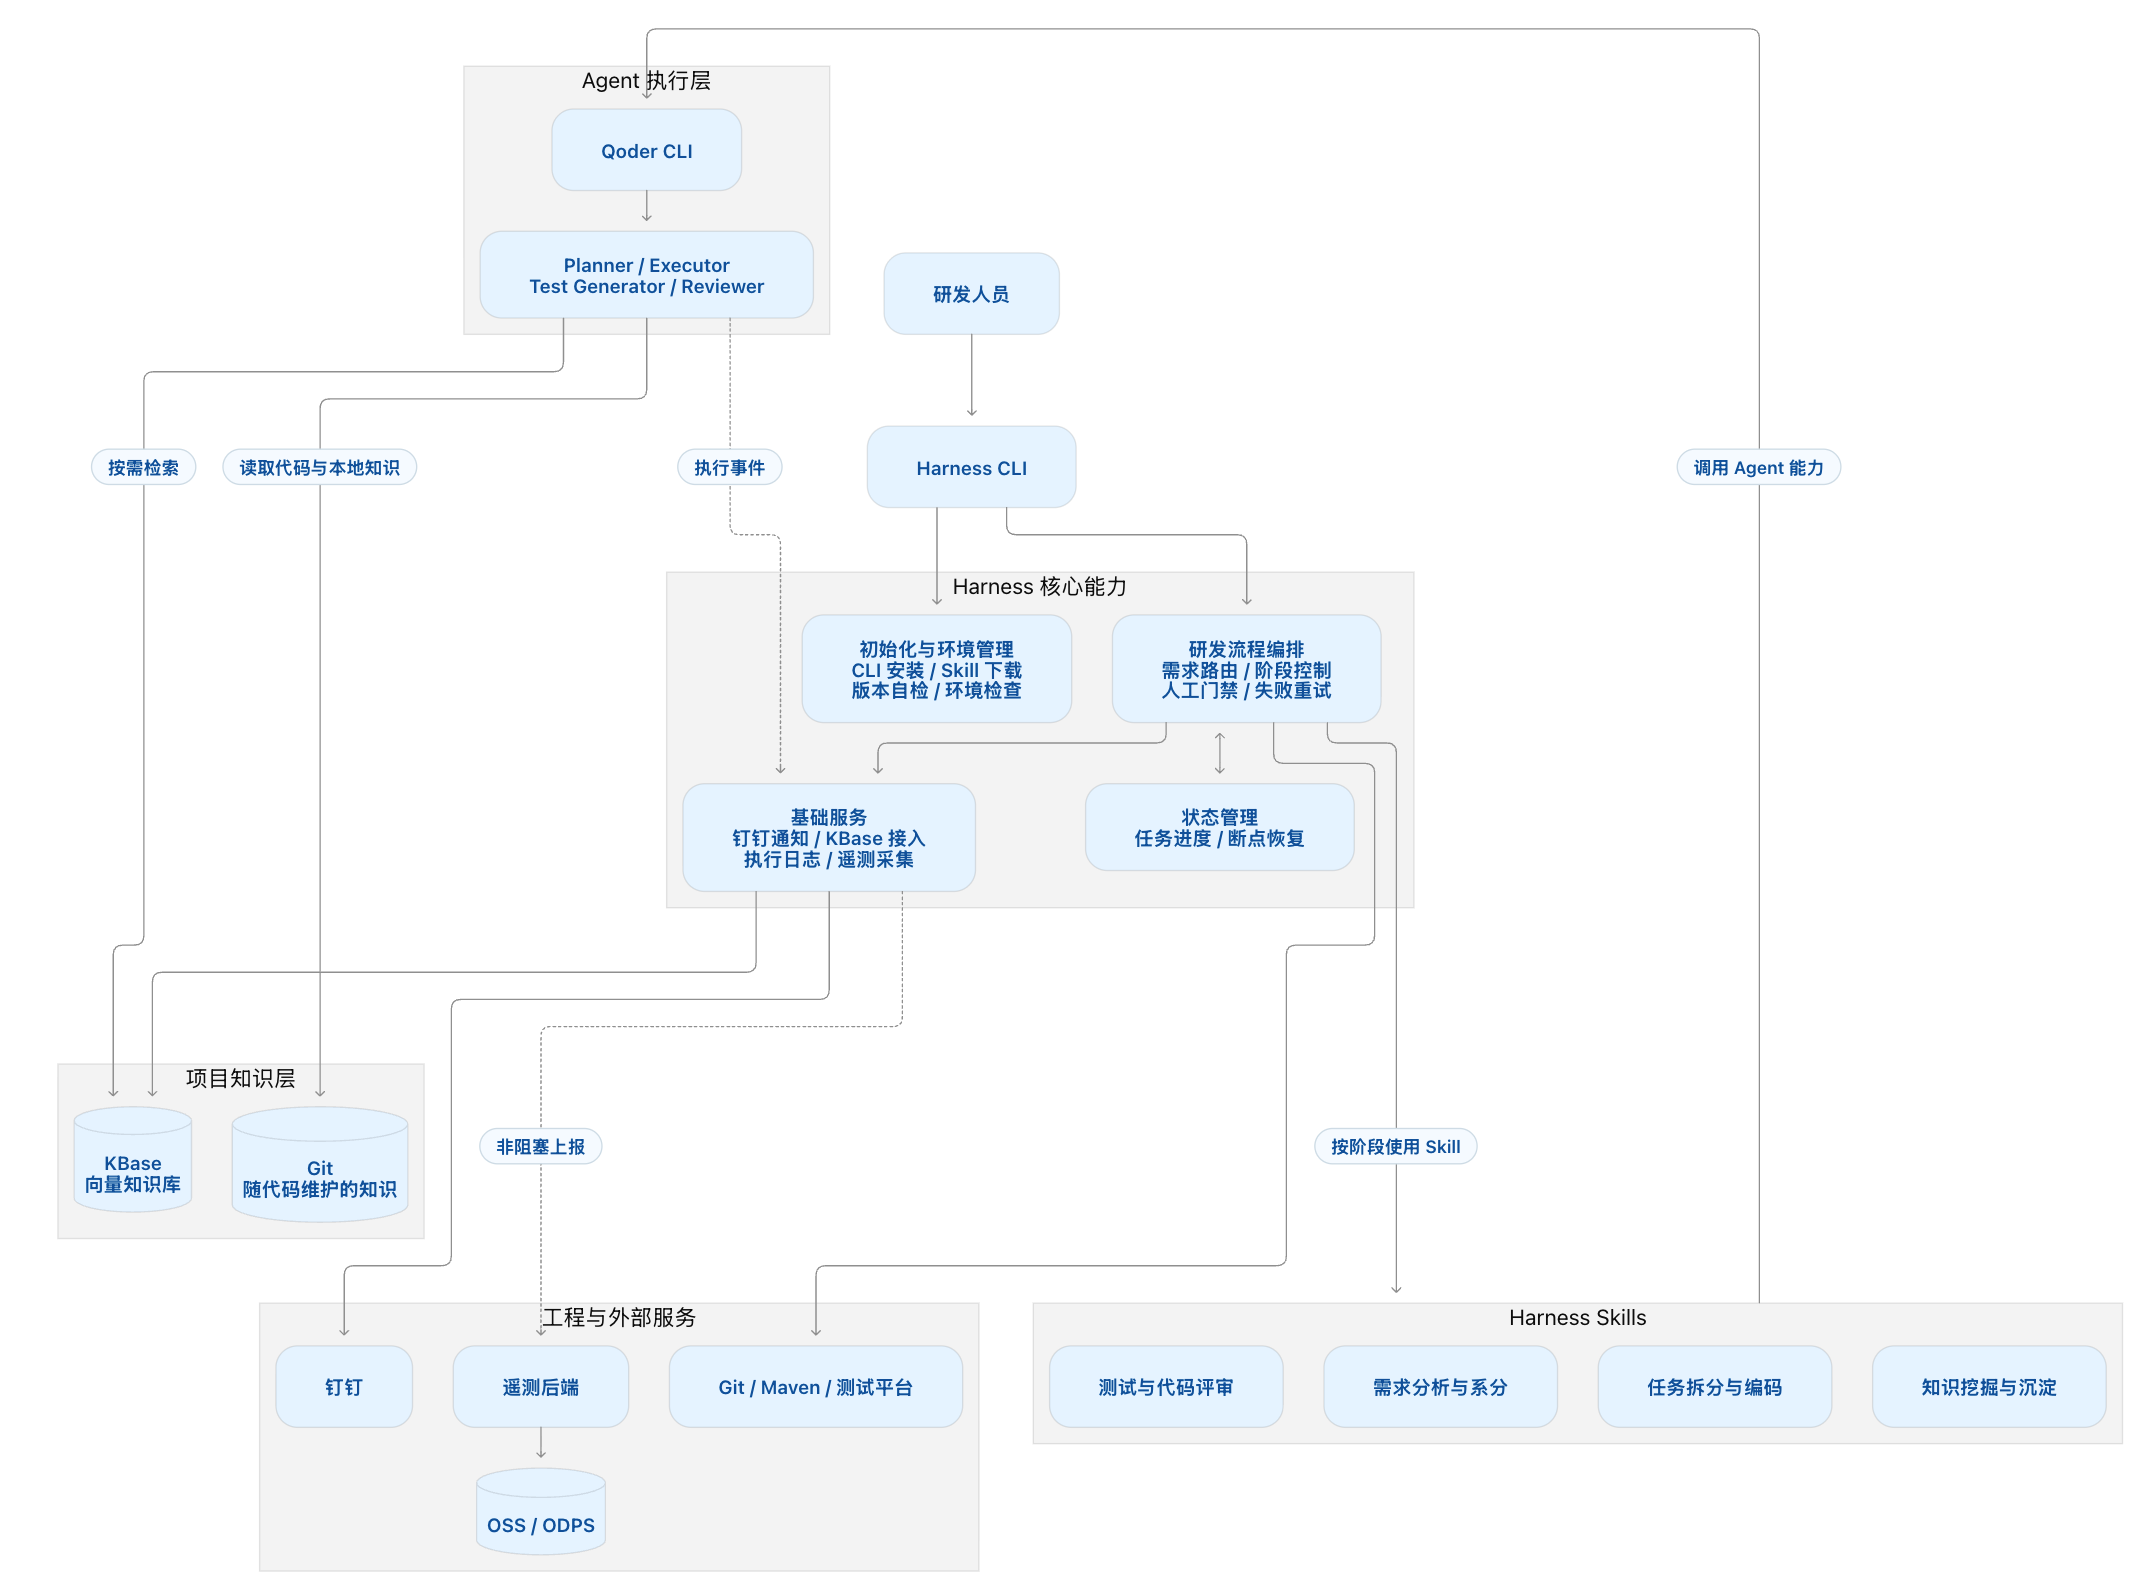
从图上看:
- 研发人员通过 Harness CLI 进入流程,CLI 连接核心能力的四个模块:初始化与环境管理、研发流程编排、基础服务、状态管理;
- Harness Skills 分四类(需求分析与系分、任务拆分与编码、测试与代码评审、知识挖掘与沉淀),按阶段调用 Agent 能力;
- 项目知识层有两个来源:KBase 向量知识库和随代码维护的 Git 知识文件,Agent 按需检索,而不是全量塞进 Prompt;
- 工程与外部服务(钉钉通知、遥测后端、Git/Maven/测试平台)通过非阻塞上报和标准工具链接入。
# 二、端到端全景
整个框架分成四个部分:
- 离线准备:Onboarding、知识挖掘,形成 Git 项目知识与 KBase 向量知识;
- 在线研发:从 PRD 到编码、质量验证、部署、QA 测试、人工验收、MR;
- 交付后知识治理:记忆飞轮、漂移检查、知识修正,形成闭环;
- 横向支撑:Harness CLI 编排、Agent 上下文、状态恢复、遥测,贯穿执行过程。
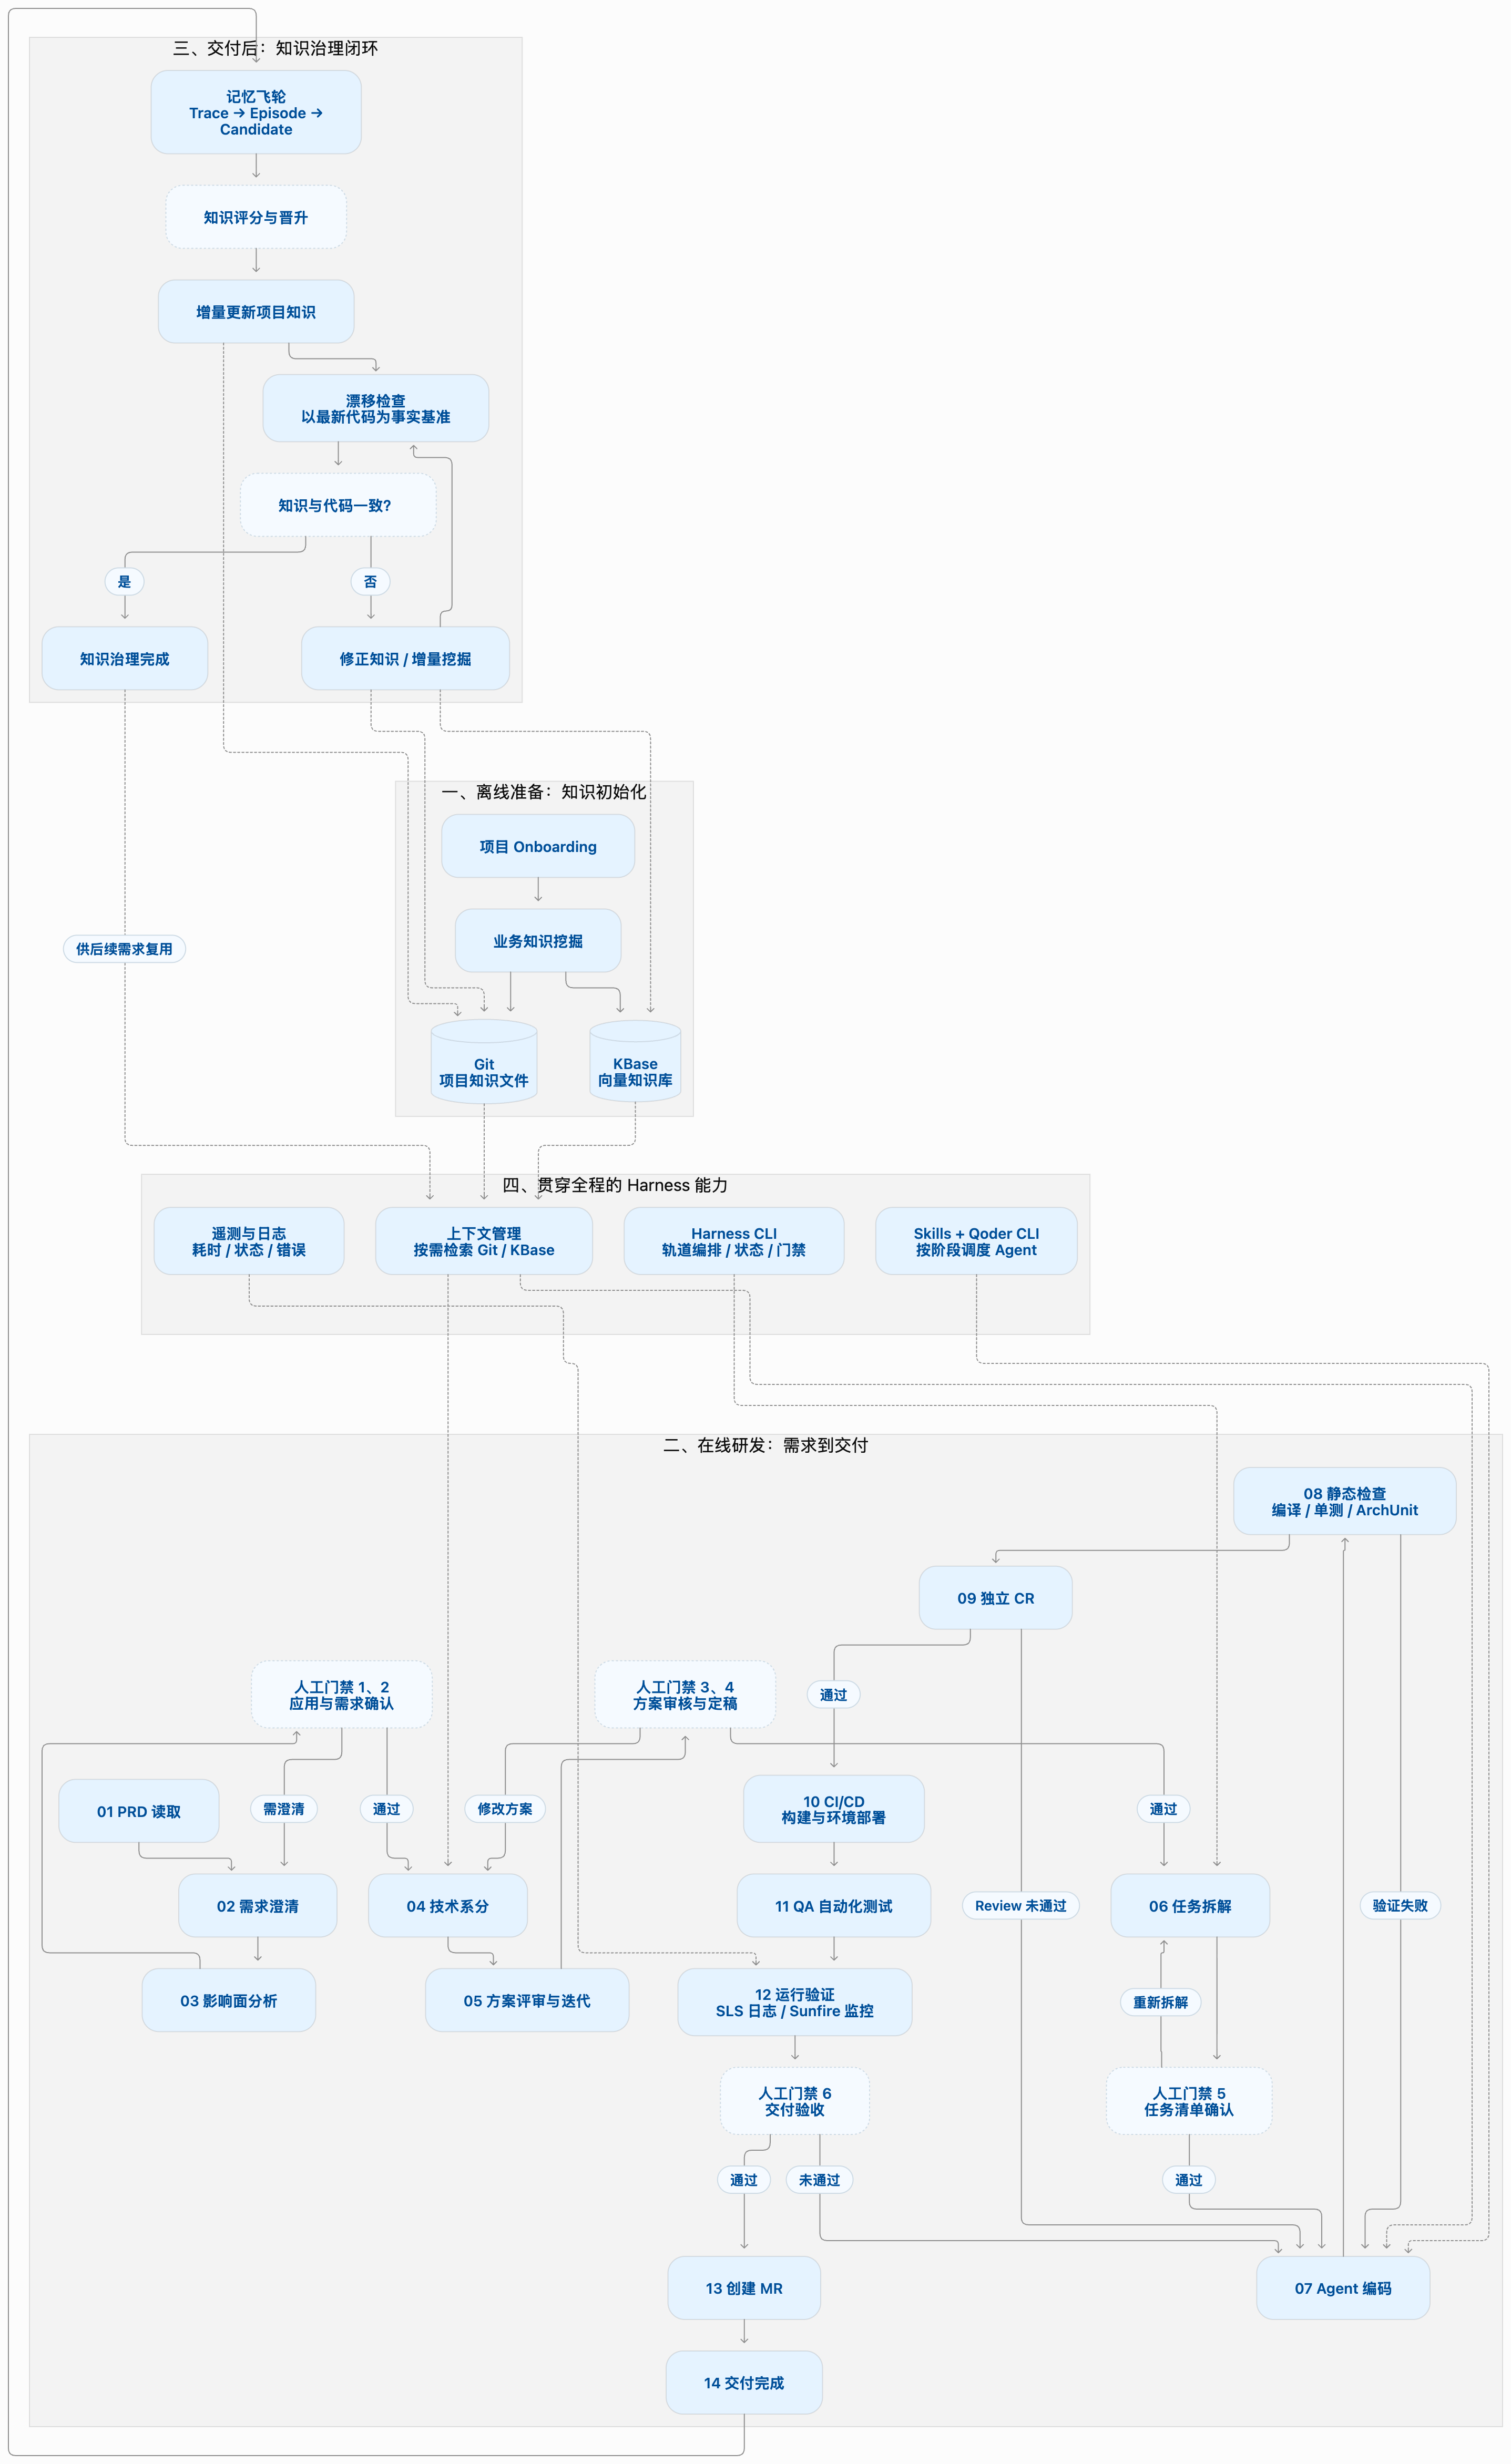
图中的在线研发部分有 14 个步骤和 6 道人工门禁:01 PRD 读取 → 02 需求澄清 → 03 影响面分析 → 04 技术系分 → 05 方案评审与迭代(门禁 1–4)→ 06 任务拆解 → 07 Agent 编码 → 08 静态检查/编译/单测/ArchUnit → 09 独立 CR → 10 CI/CD → 11 QA 自动化测试 → 12 运行验证 → 13 创建 MR → 14 交付完成。
后面章节按这条主线展开。
# 三、起点:项目接入与知识挖掘
# Onboarding:让项目具备接入条件
新项目接入时,通过 harness-onboarding 这个 Skill(执行角色叫 harness-onboarder)生成初始知识层,主要产出两样东西:
AGENTS.md(项目说明,放在仓库根目录):模块结构、编码规范、禁区、接口表、依赖表、踩坑记录和可复用能力索引;.harness/knowledge/目录:按用途拆成多个文件。
流程会检查 AGENTS.md 至少 30 行、且包含"模块结构/编码规范/踩坑"等关键词;knowledge/ 不能为空。不达标就停下补齐,不让 AI 在没有上下文时开工。
# AGENTS.md 里的内容是怎么来的
| 内容 | 怎么知道 |
|---|---|
| 模块结构 | 扫代码目录、包名、类名,看实际组织方式 |
| 接口表、依赖表 | 扫代码里的接口声明、调用关系、Maven/Gradle 依赖 |
| 可复用能力索引 | 找项目里已有的工具类、通用组件、公共方法 |
| 编码规范 | 有规范文档直接读取;没有则用 Mode K:先跑脚本粗扫实际写法,再让 AI 对比通用规范,总结项目真正在用的约定 |
| 踩坑记录 | 从已有文档、git commit 和 MR 描述里找;AI 精读时标注特殊处理、防御性代码、兼容逻辑,作为"疑似踩坑"建议人工确认 |
关键点:初始的踩坑和规范只是起点,真正成熟的内容靠流程持续补——每次需求做完、CR 之后,新经验写回这些文件(见第十节"知识沉淀")。
# 知识挖掘的文件对照
| 英文文件名 | 中文含义 | 怎么来的 |
|---|---|---|
catalog.md | 知识索引 | 脚本自动重建,列出所有知识条目 |
modules.md | 模块职责地图 | AI 精读时整理 |
coding-conventions.md | 编码规范 | Mode K:脚本粗扫 + AI 对比 |
cr-wisdom.md | CR 评论经验 | Mode D:从已合并 MR 的评论里挖 |
commit-patterns.md | commit 变更模式 | Mode E:从 git log 分析文件共变关系 |
db-models.md | 数据模型说明 | Mode I:扫 DO 类 + AI 精读 |
_topology/ | 服务拓扑 | Mode J:emonitor 拉接口 + AI 整理上下游 |
enums.md | 枚举语义 | tree-sitter 抽取 + AI 补语义 |
business.md | 业务规则 | AI 精读代码 + 注释 + 文档 |
call-chains.md | 调用链与数据流 | tree-sitter + AI 分析 |
reusable-components.md | 可复用组件 | 脚本扫 + AI 确认调用约定 |
acceptance-criteria.md | 验收标准 | AI 整理,Validator 逐条对照 |
MEMORY.md | 跨会话经验 | 只有经验管线(Mode C)可以写,评分通过才入库 |
# bkm / ckm / human 三种标记
这三个是团队自己定义的标记,不是开源标准:
bkm= Business Knowledge Mining:通过 BKM 工具自动挖出来的知识;ckm= Code Knowledge Mining:从代码结构本身挖出来的知识;human= 人写的,重跑挖掘时不会被覆盖。
bkm 和 ckm 的区别:
| bkm(自动挖掘) | ckm(代码挖掘) | |
|---|---|---|
| 数据来源 | PRD、系分文档、CR 评论、人工反馈、执行 trace | 代码文件本身:类名、方法签名、调用关系、枚举 |
| 怎么做 | AI 精读业务文档和经验材料,提炼规则 | tree-sitter + grep 扫代码结构,AI 补语义 |
| 产出类型 | 业务规则、决策表、经验教训 | 模块结构、接口表、枚举含义、调用链 |
| 典型文件 | MEMORY.md、cr-wisdom.md | modules.md、enums.md、call-chains.md |
# tree-sitter 是什么
tree-sitter 是 GitHub 开源项目(MIT 协议,Rust + C),能把源代码解析成语法树(AST)。它不懂业务含义,但能精确告诉你"这个枚举属于哪个类、在第几行"——所以用来做结构级粗扫,语义部分交给 AI 精读。
# 四、需求分析与方案
流程开始前有 4 步准备:
| 步骤 | 干什么 |
|---|---|
| Step -1 状态恢复 | 读 state.json,有中断任务就继续跑 |
| Step 0 环境检查 | 检查运行时、依赖、工具链是否就绪 |
| Step 1 抓取 PRD | 从钉钉文档拿原文,落成 prd-original.md |
| Step 1.5 应用路由 + 知识层就绪检查 | 全局路由表匹配应用;检查 AGENTS.md 和知识目录,不达标就触发 onboarding 或知识挖掘 |
然后是方案阶段,4 步 + 3 道人工确认:
| 步骤 | 干什么 |
|---|---|
| Step 2.1.5 生成反问清单 | AI 对照代码,把需求里没讲清楚的地方列出来 |
| 人工门禁 2 | 产品或研发回答反问清单 |
| Step 2.2 生成系分 v1 | 基于知识层 + 用户回答,写出技术方案 |
| 人工门禁 3 | 研发 review 系分 v1,给反馈 |
| Step 2.5 系分迭代 | 根据反馈出系分 v2,最多 3 轮 |
| 人工门禁 4 | 确认系分定稿 |
| Step 2.7 自动验证系分质量 | 覆盖率、内部矛盾、改动落点、引用类存在(硬阻断)、稳定性自查 5 项检查 |
这里人工价值最大:6 句话反馈就能把系分覆盖率从 44% 拉到 75%。
其中 Step 2.7 的自动验证不是简单跑个脚本,而是有前置条件和多维度校验,具体流程见第八节"D1 如何保证确定性"。
# 五、任务拆分与编码(C1–C12)
| 步骤 | 干什么 | 为什么要有 |
|---|---|---|
| C1 拉取仓库并建分支 | 获取最新代码,创建工作分支 | 保证从最新状态开始 |
| C2 BKM 增量判定 | 判断是否需要重新挖知识(>10 文件才触发) | 避免每次全量重挖 |
| C3 记忆检索 | 按需读取相关经验和知识,预算 3000 行 | 给够上下文但不撑爆 |
| C4 知识层就绪门禁 | 再检查 AGENTS.md 和经验凭证 | 确保编码前知识完整 |
| C5 注入领域知识 | 把知识文件路径(不是全文)给 coder | 让 coder 按需读,避免编排层 prompt 超长 |
| C6 分支防护 | 确认当前分支没被别人改过 | 避免并行冲突 |
| C7 Planner 拆任务 | 系分拆成 tasks.md,每个任务到方法级 | 模型会低估复杂度,先拆小再动手 |
| 人工门禁 5 | 研发确认任务清单 | 人来把关改动范围 |
| C8 Executor 写代码 | 按任务分批实现,每批 ≤10 个任务,每批写 commit | 上下文有限,防止 AI 提前收工 |
| C9 Test Generator 补单测 | 基于验收用例给改动补测试 | 不能只写代码不写测试 |
| C10 Validator 自动验证 | 跑编译 + 单测 + ArchUnit | 语法、行为、架构三层都查 |
| C11 CR 终审 | 独立 CR Agent 检查(可换不同模型) | 写代码的 AI 不能自评,必须有独立审查 |
| C12 漂移检查 | 拿最新代码反查文档 | 代码改了,文档可能没跟上 |
# 一次编码任务的完整调用链
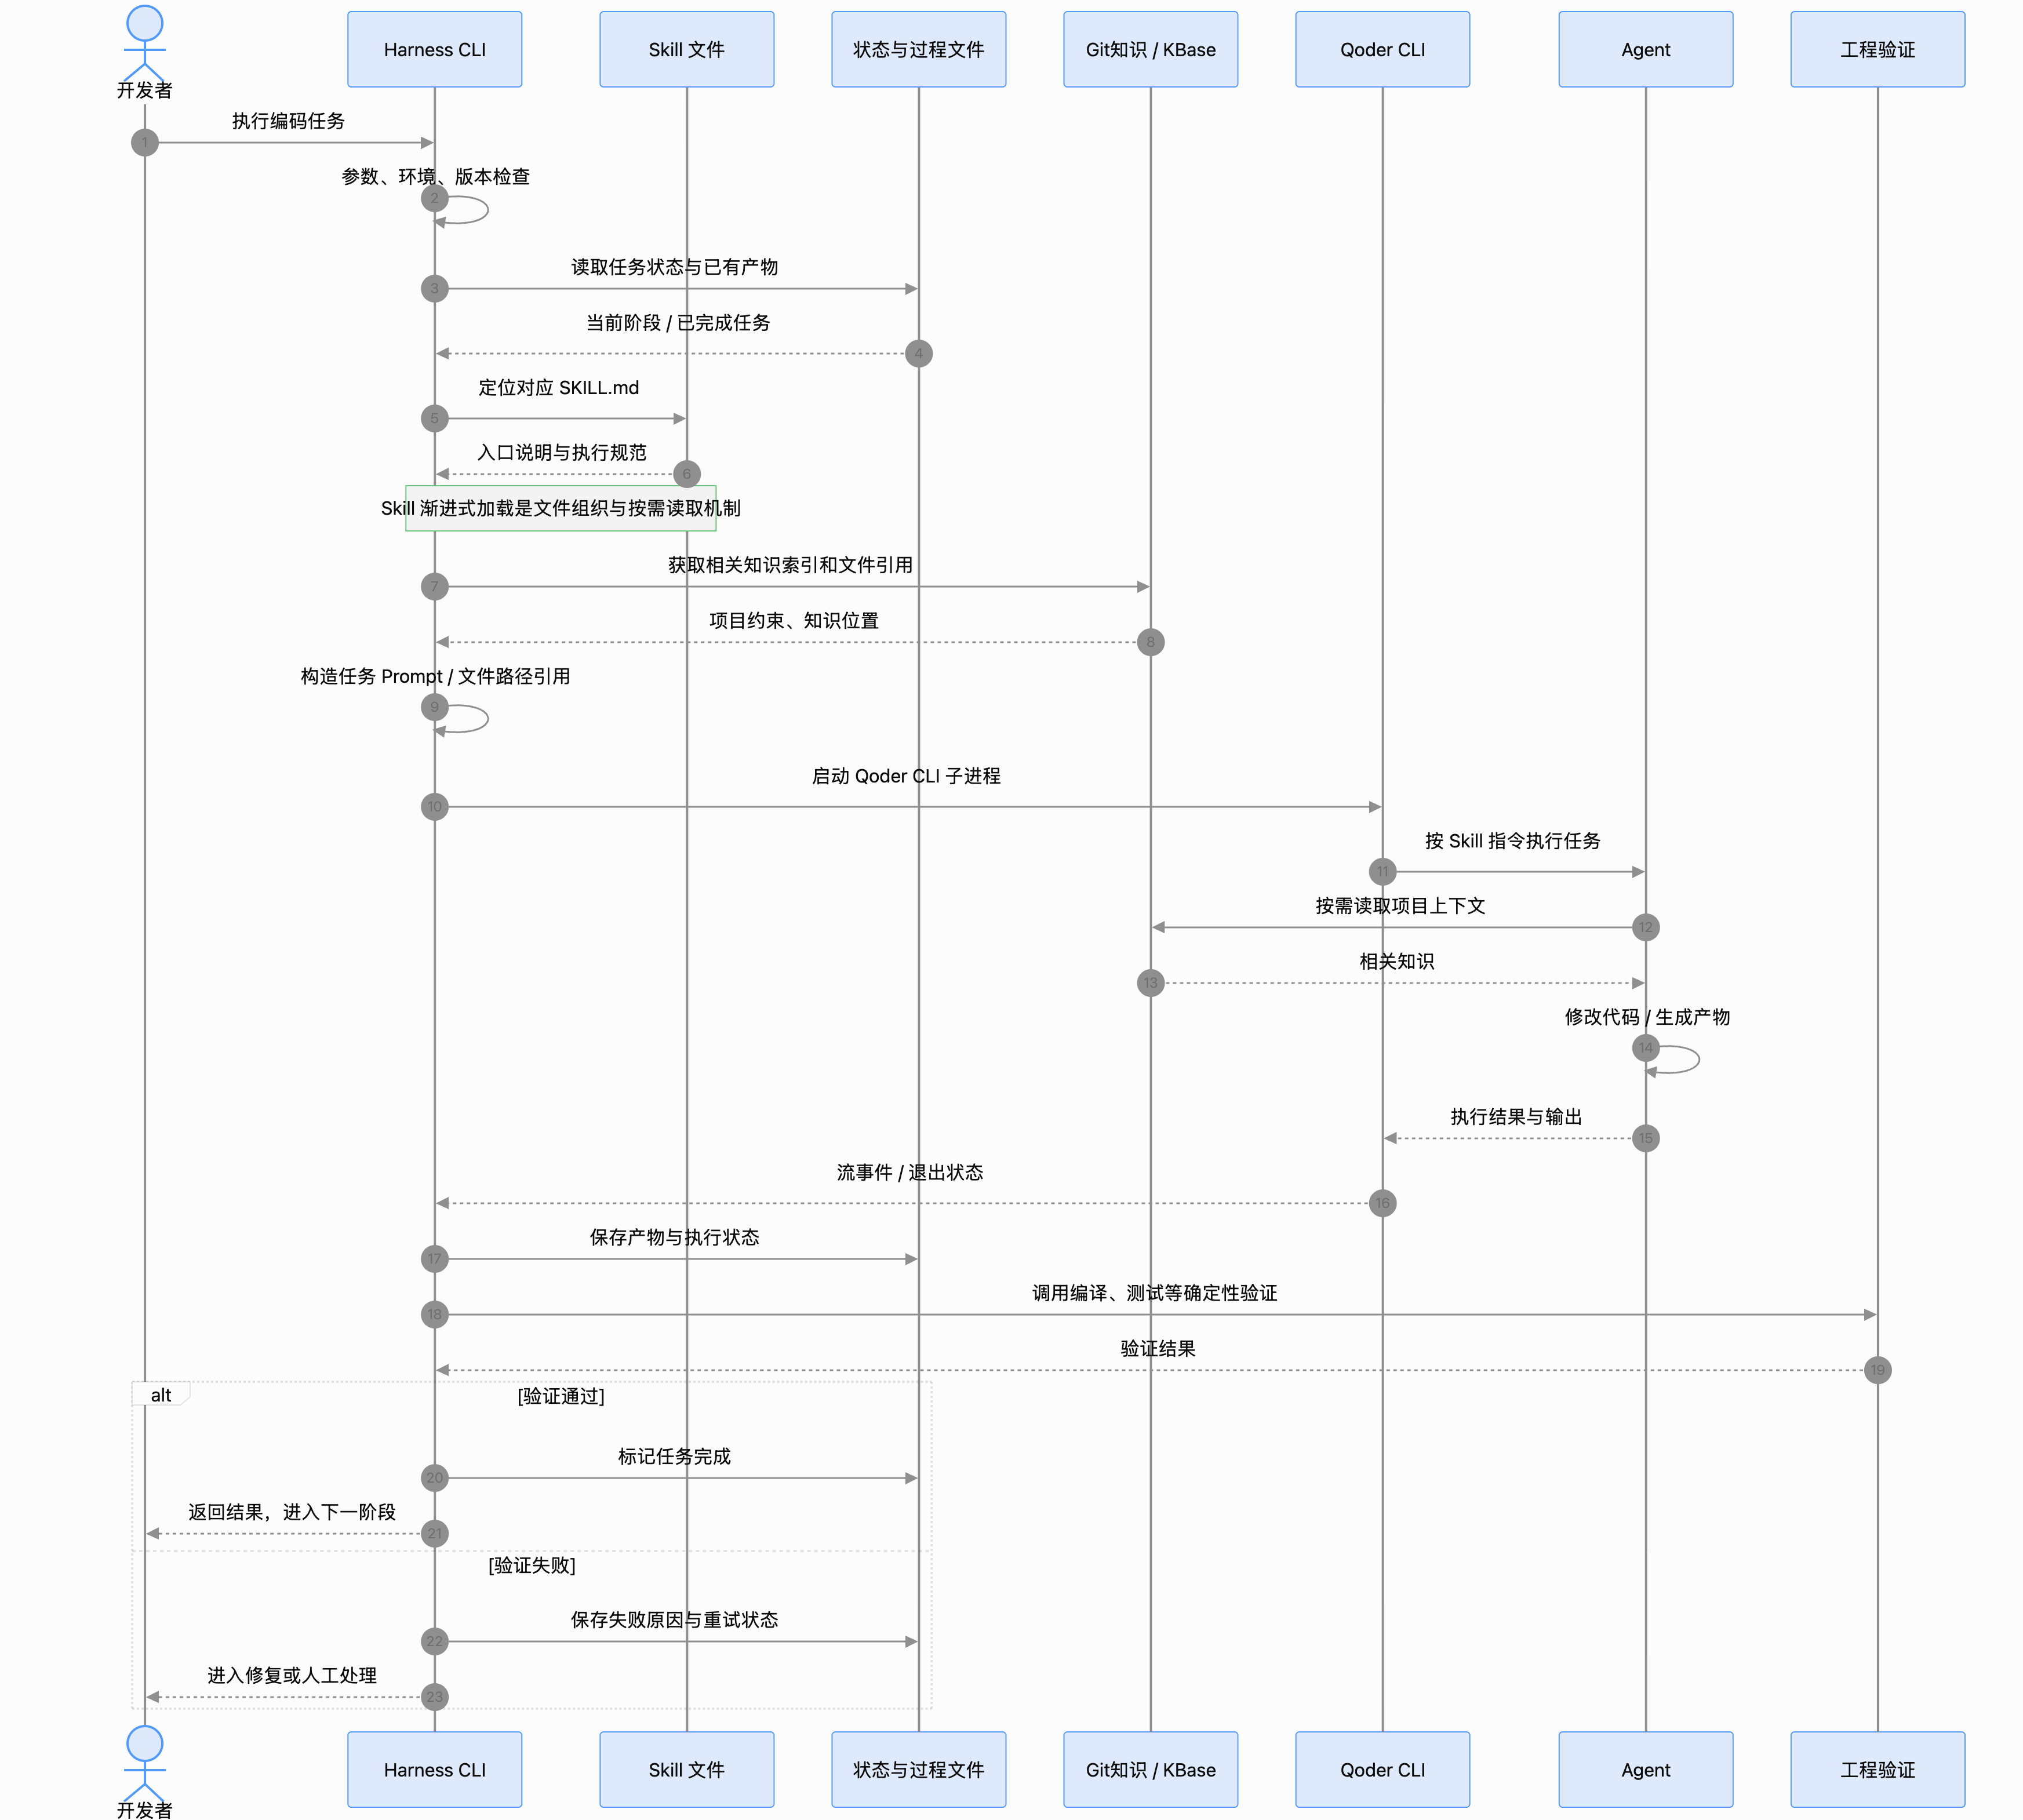
下面这张时序图展示的是 C1–C12 中一次编码任务从启动到验证的完整调用链,对应的就是"Skill 和 CLI 解耦、上下文按需加载"这两个设计在实际执行中的样子:
关键环节:
- 前置检查:开发者执行编码任务后,CLI 先做参数、环境、版本检查,再从状态文件读取任务状态与已有产物——这就是断点恢复的入口;
- Skill 渐进式加载:CLI 定位对应
SKILL.md,拿到入口说明和执行规范。Skill 渐进式加载是文件组织与按需读取机制,不是一次性把所有内容塞进 Prompt; - 知识索引注入:CLI 从 Git 知识 / KBase 获取相关知识索引和文件引用,构造任务 Prompt 时只带文件路径引用;
- Agent 执行:CLI 启动 Qoder CLI 子进程,Agent 按 Skill 指令执行任务,按需读取项目上下文,修改代码并生成产物;
- 确定性验证:结果保存后,CLI 调用编译、测试等确定性验证——验证通过则标记任务完成进入下一阶段;验证失败则保存失败原因与重试状态,进入修复或人工处理。
# 修复不是无限重试
- Validator 失败最多修 2 次;
- 重新拆任务最多 1 次;
- CR 发现问题每个最多修 3 次;
- 置信度低于 50 直接交给人。
所有重试有上限,超了就停。
# CR Agent 四层审查
| 层 | 查什么 |
|---|---|
| 第 1 层 | 通用 Java 开发规约 |
| 第 2 层 | 项目 AGENTS.md 里的约定 |
| 第 3 层 | MEMORY.md 里的历史踩坑 |
| 第 4 层 | 系分文档里的验收用例 |
审查结论强制分三类:方向错(必须返工)、细节缺失(补齐即可)、风格问题(可选)。这个分类让"要不要打回"变成机器可判断。
# 六、验收与交付
| 步骤 | 干什么 |
|---|---|
| Step 6.0 自动预检 | 逐条对照 acceptance-criteria.md,看验收条件是否满足 |
| Step 6.0.1 CRITICAL 修复环 | 严重问题编排层不许自己改代码,必须委托编码角色修,且只给 1 次机会 |
| Step 6.1.1 生成交付度量 | 耗时、任务数、测试结果写进 delivery-metrics.json |
| Step 7 集成测试 | e2e 测试 + SLS 日志 + Sunfire 监控 |
| 人工门禁 6 | 研发验收,给五个选项,通过才提 MR |
验收不是"通过/不通过"二选一,而是五个具体选项(继续 / 文件不对 / 漏功能 / 方向不对 / 回滚),每个选项对应不同的回退路径。
# 七、双路径:标准流程与小需求快修
不是所有需求都需要走完整流程。框架按需求规模与风险做路由,分成两条路径:
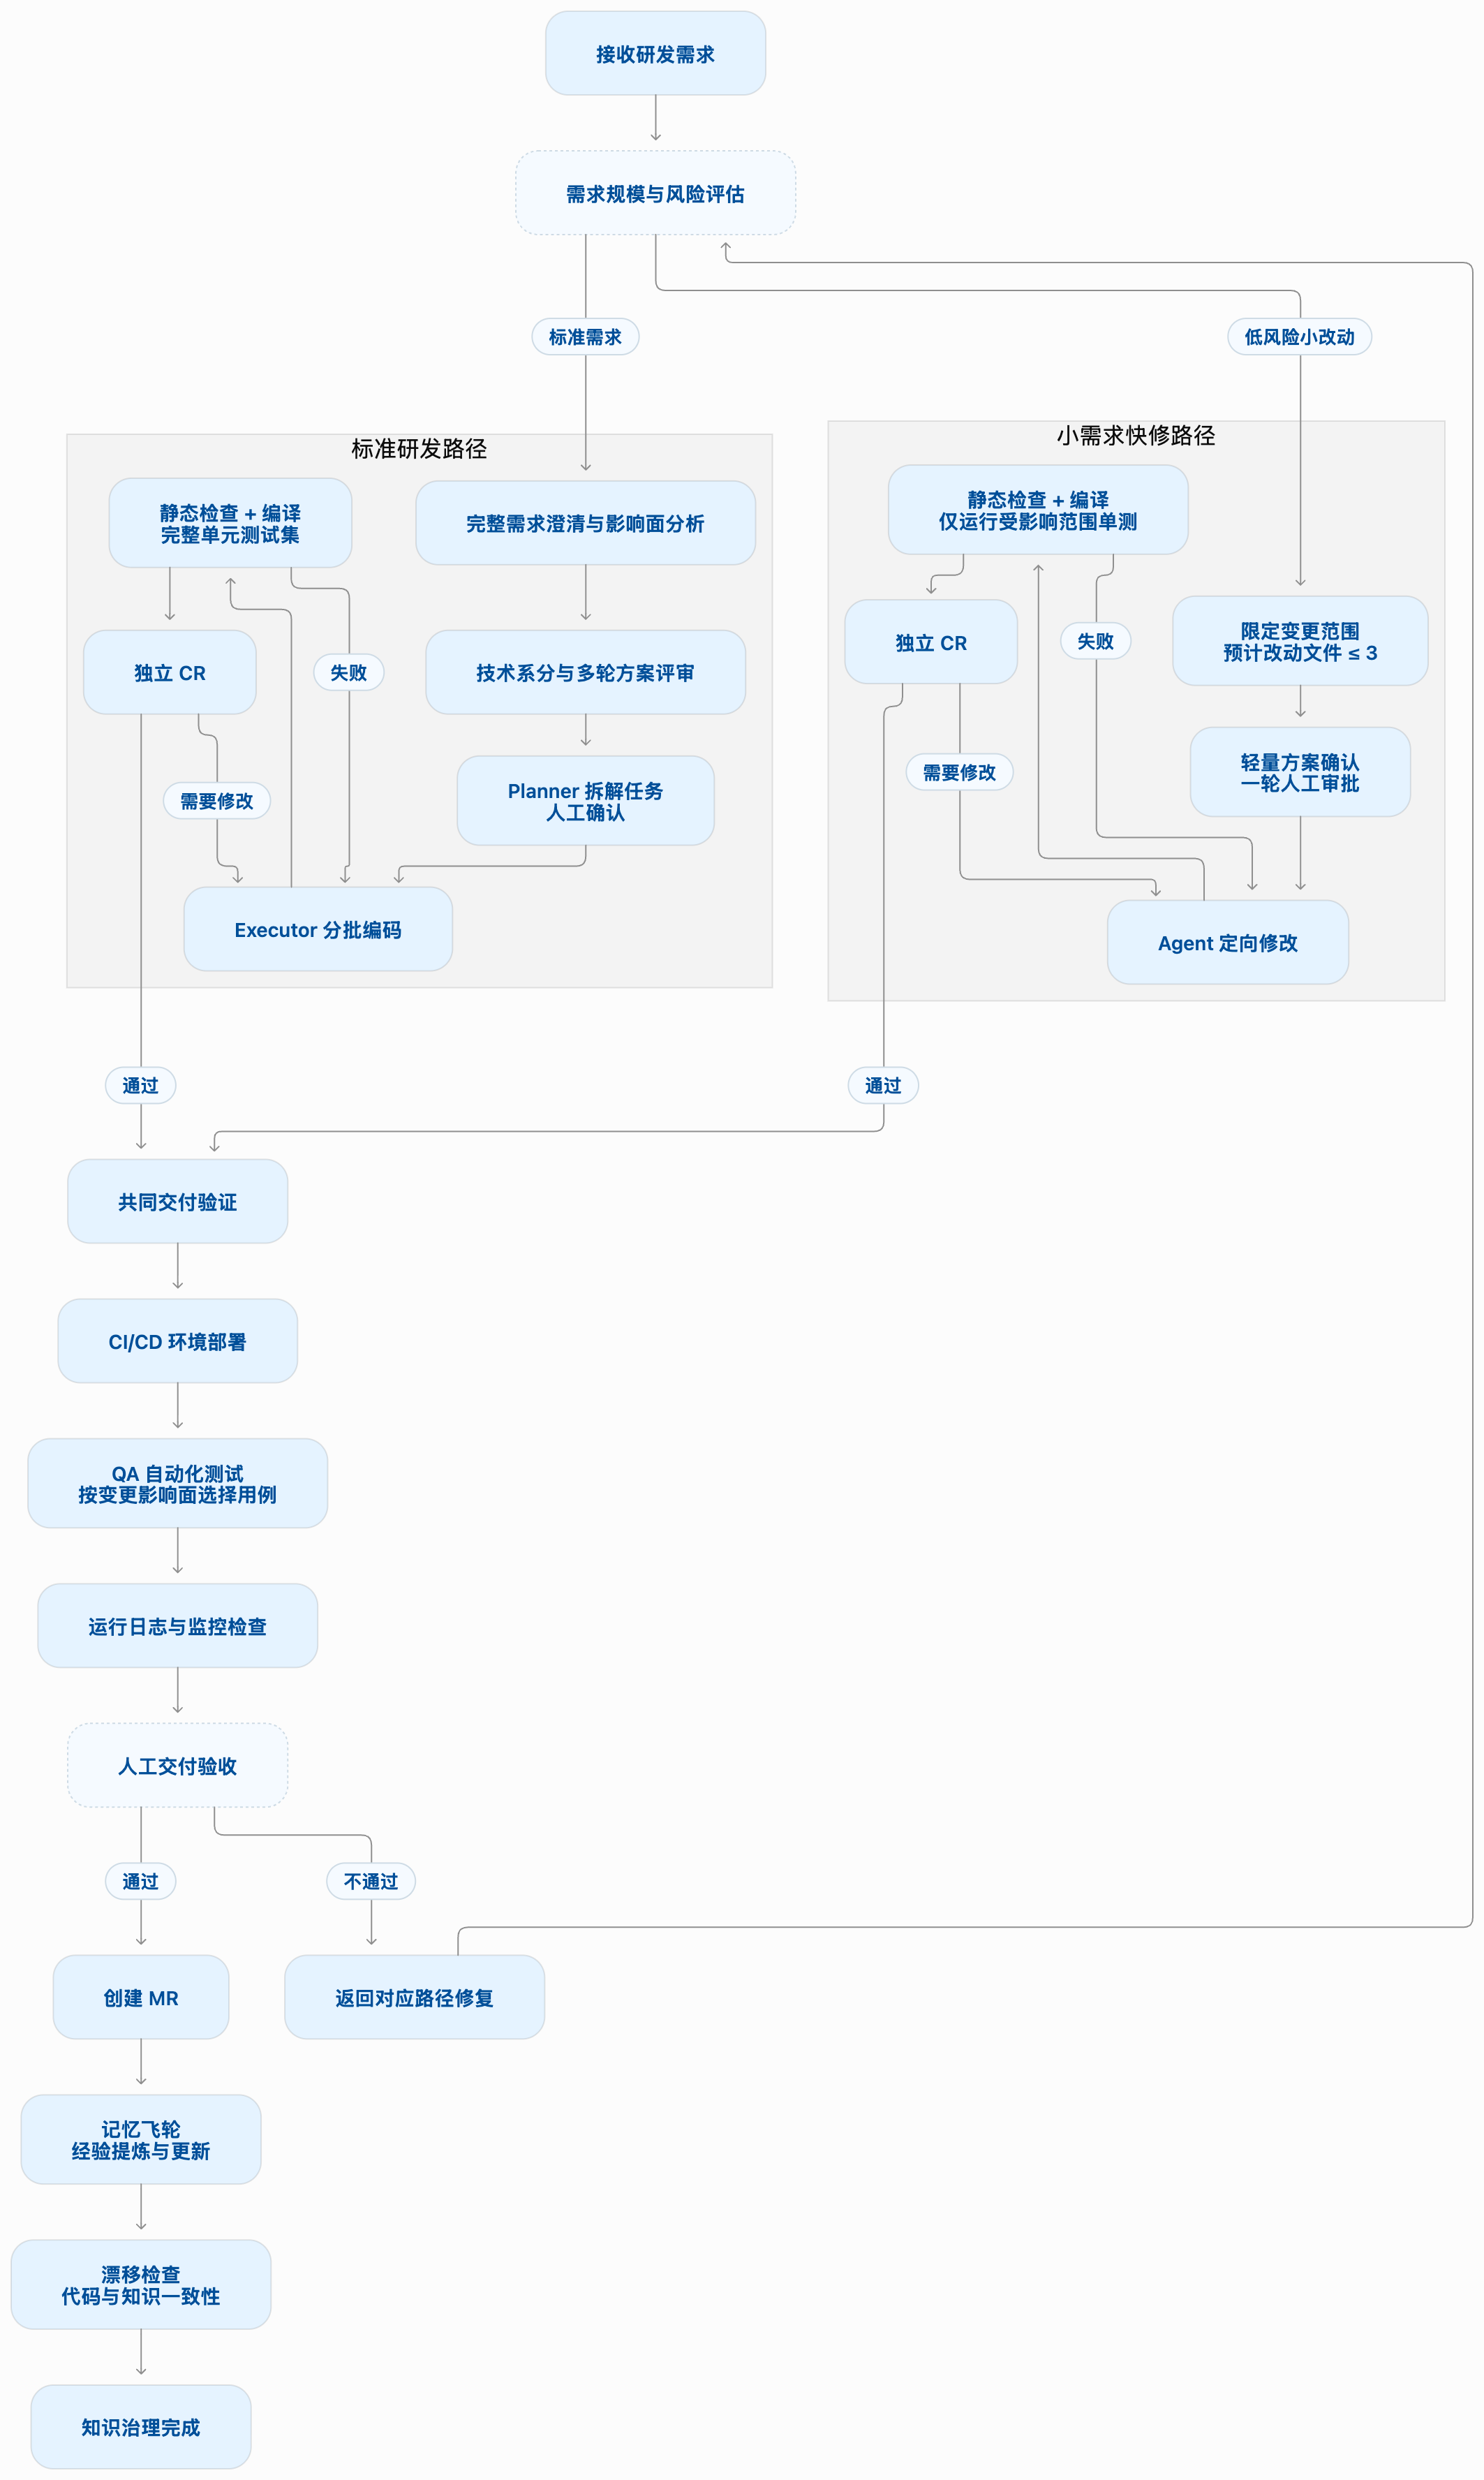
| 标准研发路径 | 小需求快修路径 | |
|---|---|---|
| 进入条件 | 标准需求 | 低风险小改动,预计改动文件 ≤ 3 |
| 需求澄清 | 完整澄清与影响面分析 | 限定变更范围 |
| 方案 | 技术系分 + 多轮评审 | 轻量方案确认,一轮人工审批 |
| 任务拆解 | Planner 拆解 + 人工确认 | 无需拆解,Agent 定向修改 |
| 验证 | 静态检查 + 编译 + 完整单测集 | 静态检查 + 编译 + 仅受影响范围单测 |
| CR | 独立 CR | 独立 CR |
两条路径在"共同交付验证"汇合:CI/CD 环境部署 → QA 自动化测试(按变更影响面选择用例)→ 运行日志与监控检查 → 人工交付验收 → 创建 MR。验收不通过则返回对应路径修复。
MR 之后两条路径共享同一个知识治理收尾:记忆飞轮(经验提炼与更新)→ 漂移检查(代码与知识一致性)→ 知识治理完成。
双路径的价值:让低风险小改动不被完整流程拖慢,同时不牺牲交付质量底线——快修路径仍然要求独立 CR 和人工验收。
# 八、执行引擎与确定性保障
前面章节讲的是"每个阶段做什么",这一节讲"这些阶段是怎么被调度和保障的"。
# D1 执行引擎:三种节点的统一调度
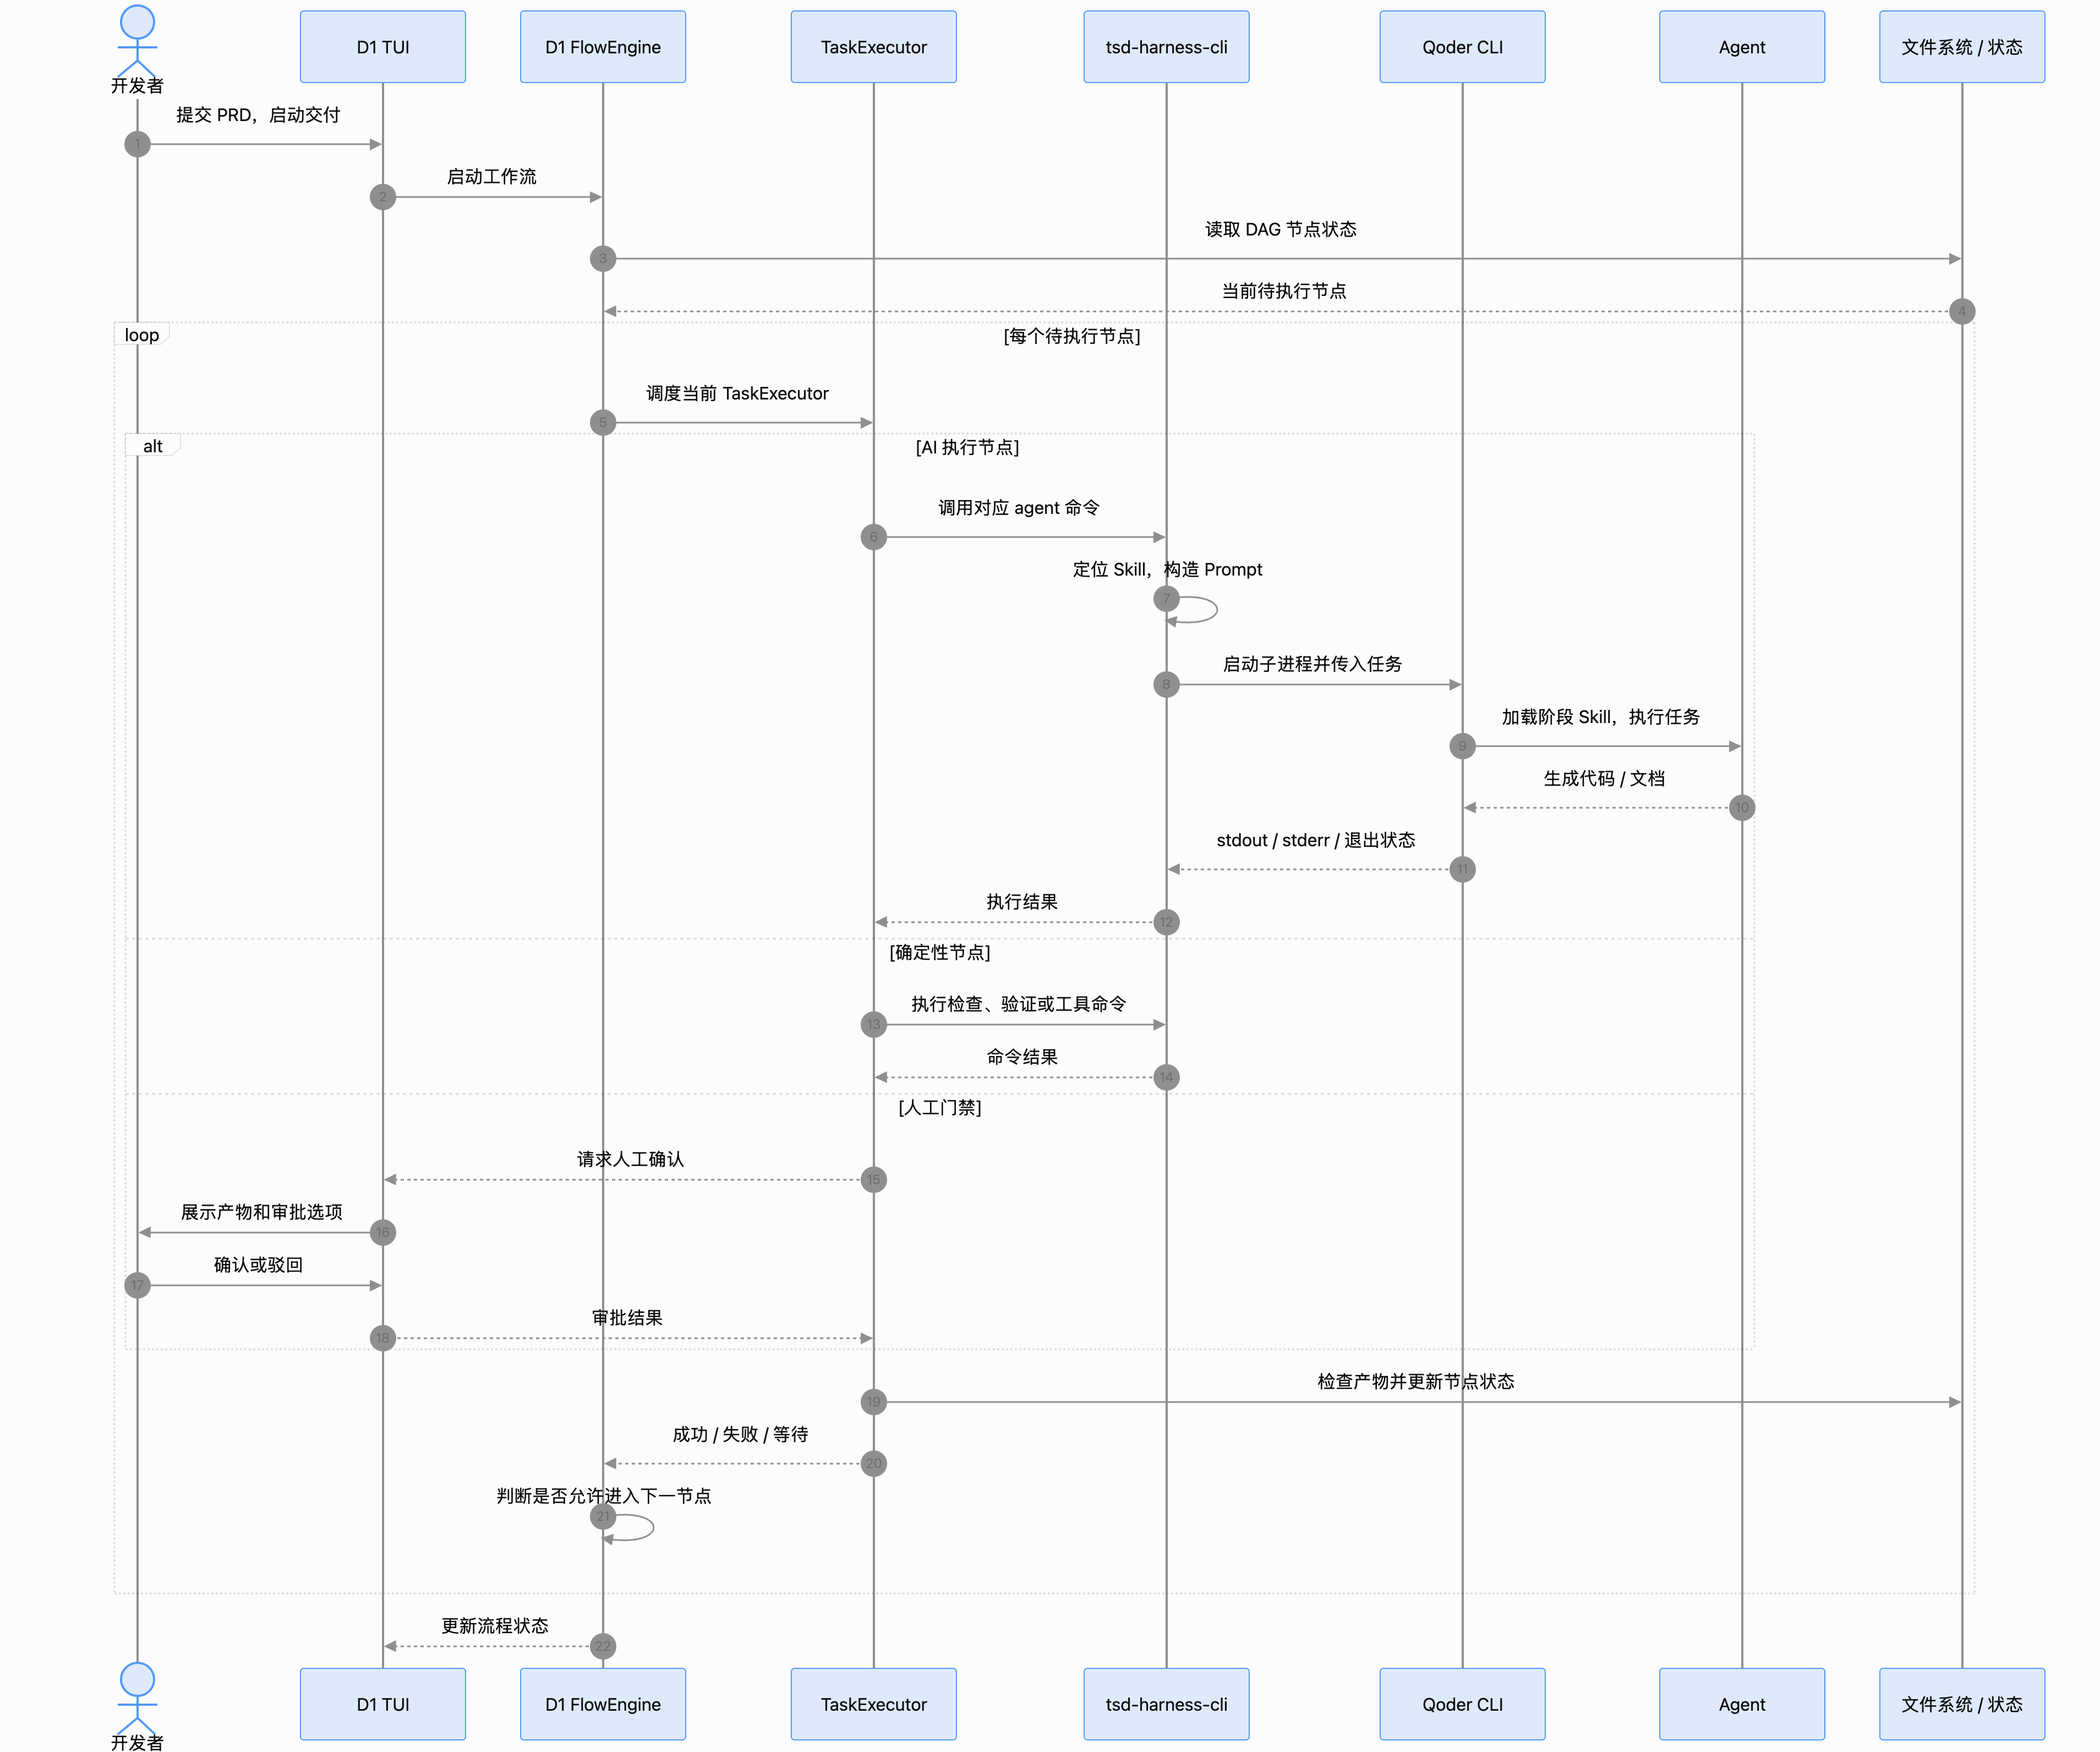
开发者提交 PRD 后,D1 FlowEngine 读取 DAG 节点状态,循环调度每个待执行节点。TaskExecutor 把节点分成三类:
- AI 执行节点:TaskExecutor 调用 tsd-harness-cli,CLI 定位 Skill、构造 Prompt,启动 Qoder CLI 子进程,Agent 加载阶段 Skill 执行任务,结果通过 stdout/stderr/退出状态返回;
- 确定性节点:直接执行检查、验证或工具命令,返回命令结果;
- 人工门禁:TaskExecutor 请求 D1 TUI 展示产物和审批选项,开发者确认或驳回,审批结果回传。
每类节点执行完后,TaskExecutor 检查产物并更新节点状态,FlowEngine 判断是否允许进入下一节点,最后更新 TUI 流程状态。
这张图回答的问题是:同一个 DAG 里既有 AI 任务、又有确定性命令、又有人工审批,怎么统一调度——答案是 TaskExecutor 按节点类型分发,CLI 只负责确定性的工程动作,人工决策通过 TUI 门禁进入。
# D1 如何保证确定性:以 Step 2.7 为例
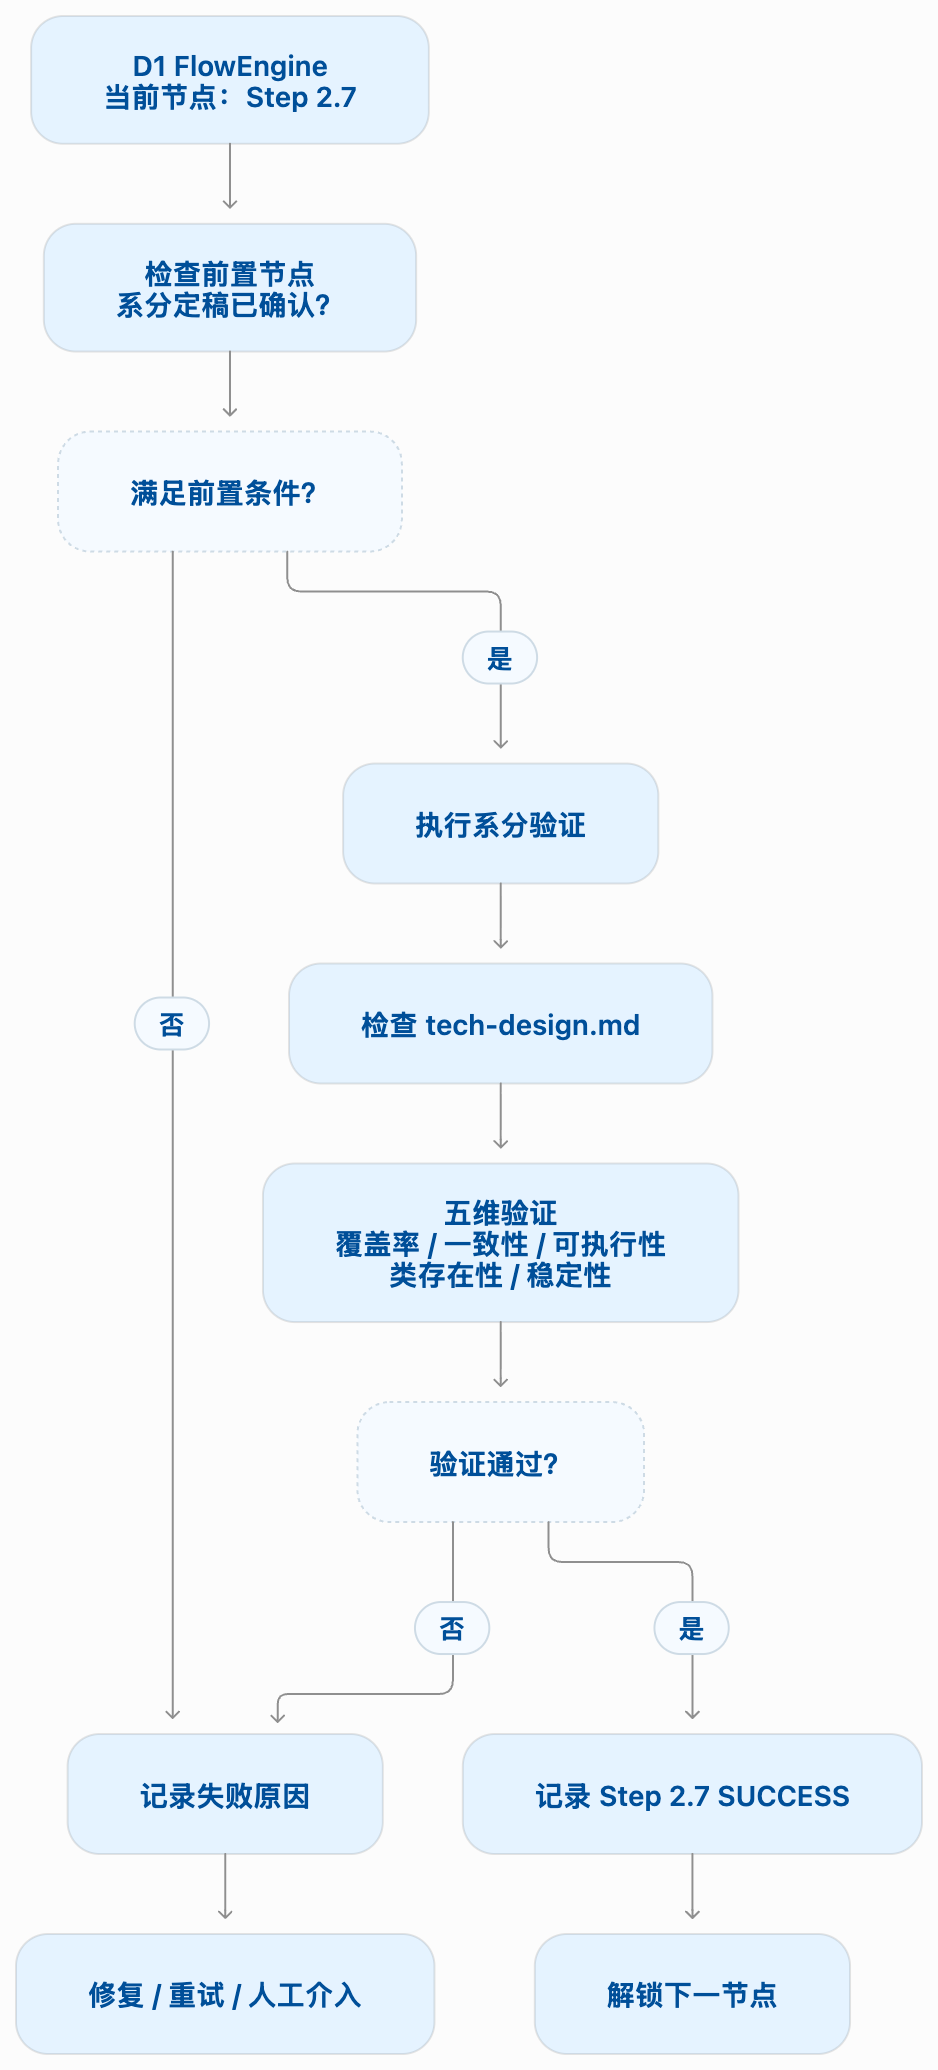
以系分验证(Step 2.7)为例,一个确定性节点的执行流程:
- 检查前置节点:系分定稿是否已确认?不满足前置条件直接走失败路径;
- 执行系分验证:检查
tech-design.md,做五维验证——覆盖率、一致性、可执行性、类存在性、稳定性; - 验证通过:记录 Step 2.7 SUCCESS,解锁下一节点;
- 验证失败:记录失败原因,进入修复/重试/人工介入。
确定性来自三层:前置条件检查(不满足就不执行)、验证内容明确(五维各有具体检查项)、失败路径明确(不是静默失败,而是记录原因后进入修复或人工介入)。
# 任务级断点恢复与有界重试
假设一个需求被拆成 10 个任务,Agent 已完成 T1~T6,执行 T7 时进程中断。重新启动后,不能直接从 T1 重做,也不能仅凭状态文件就认定 T1~T6 已完成。
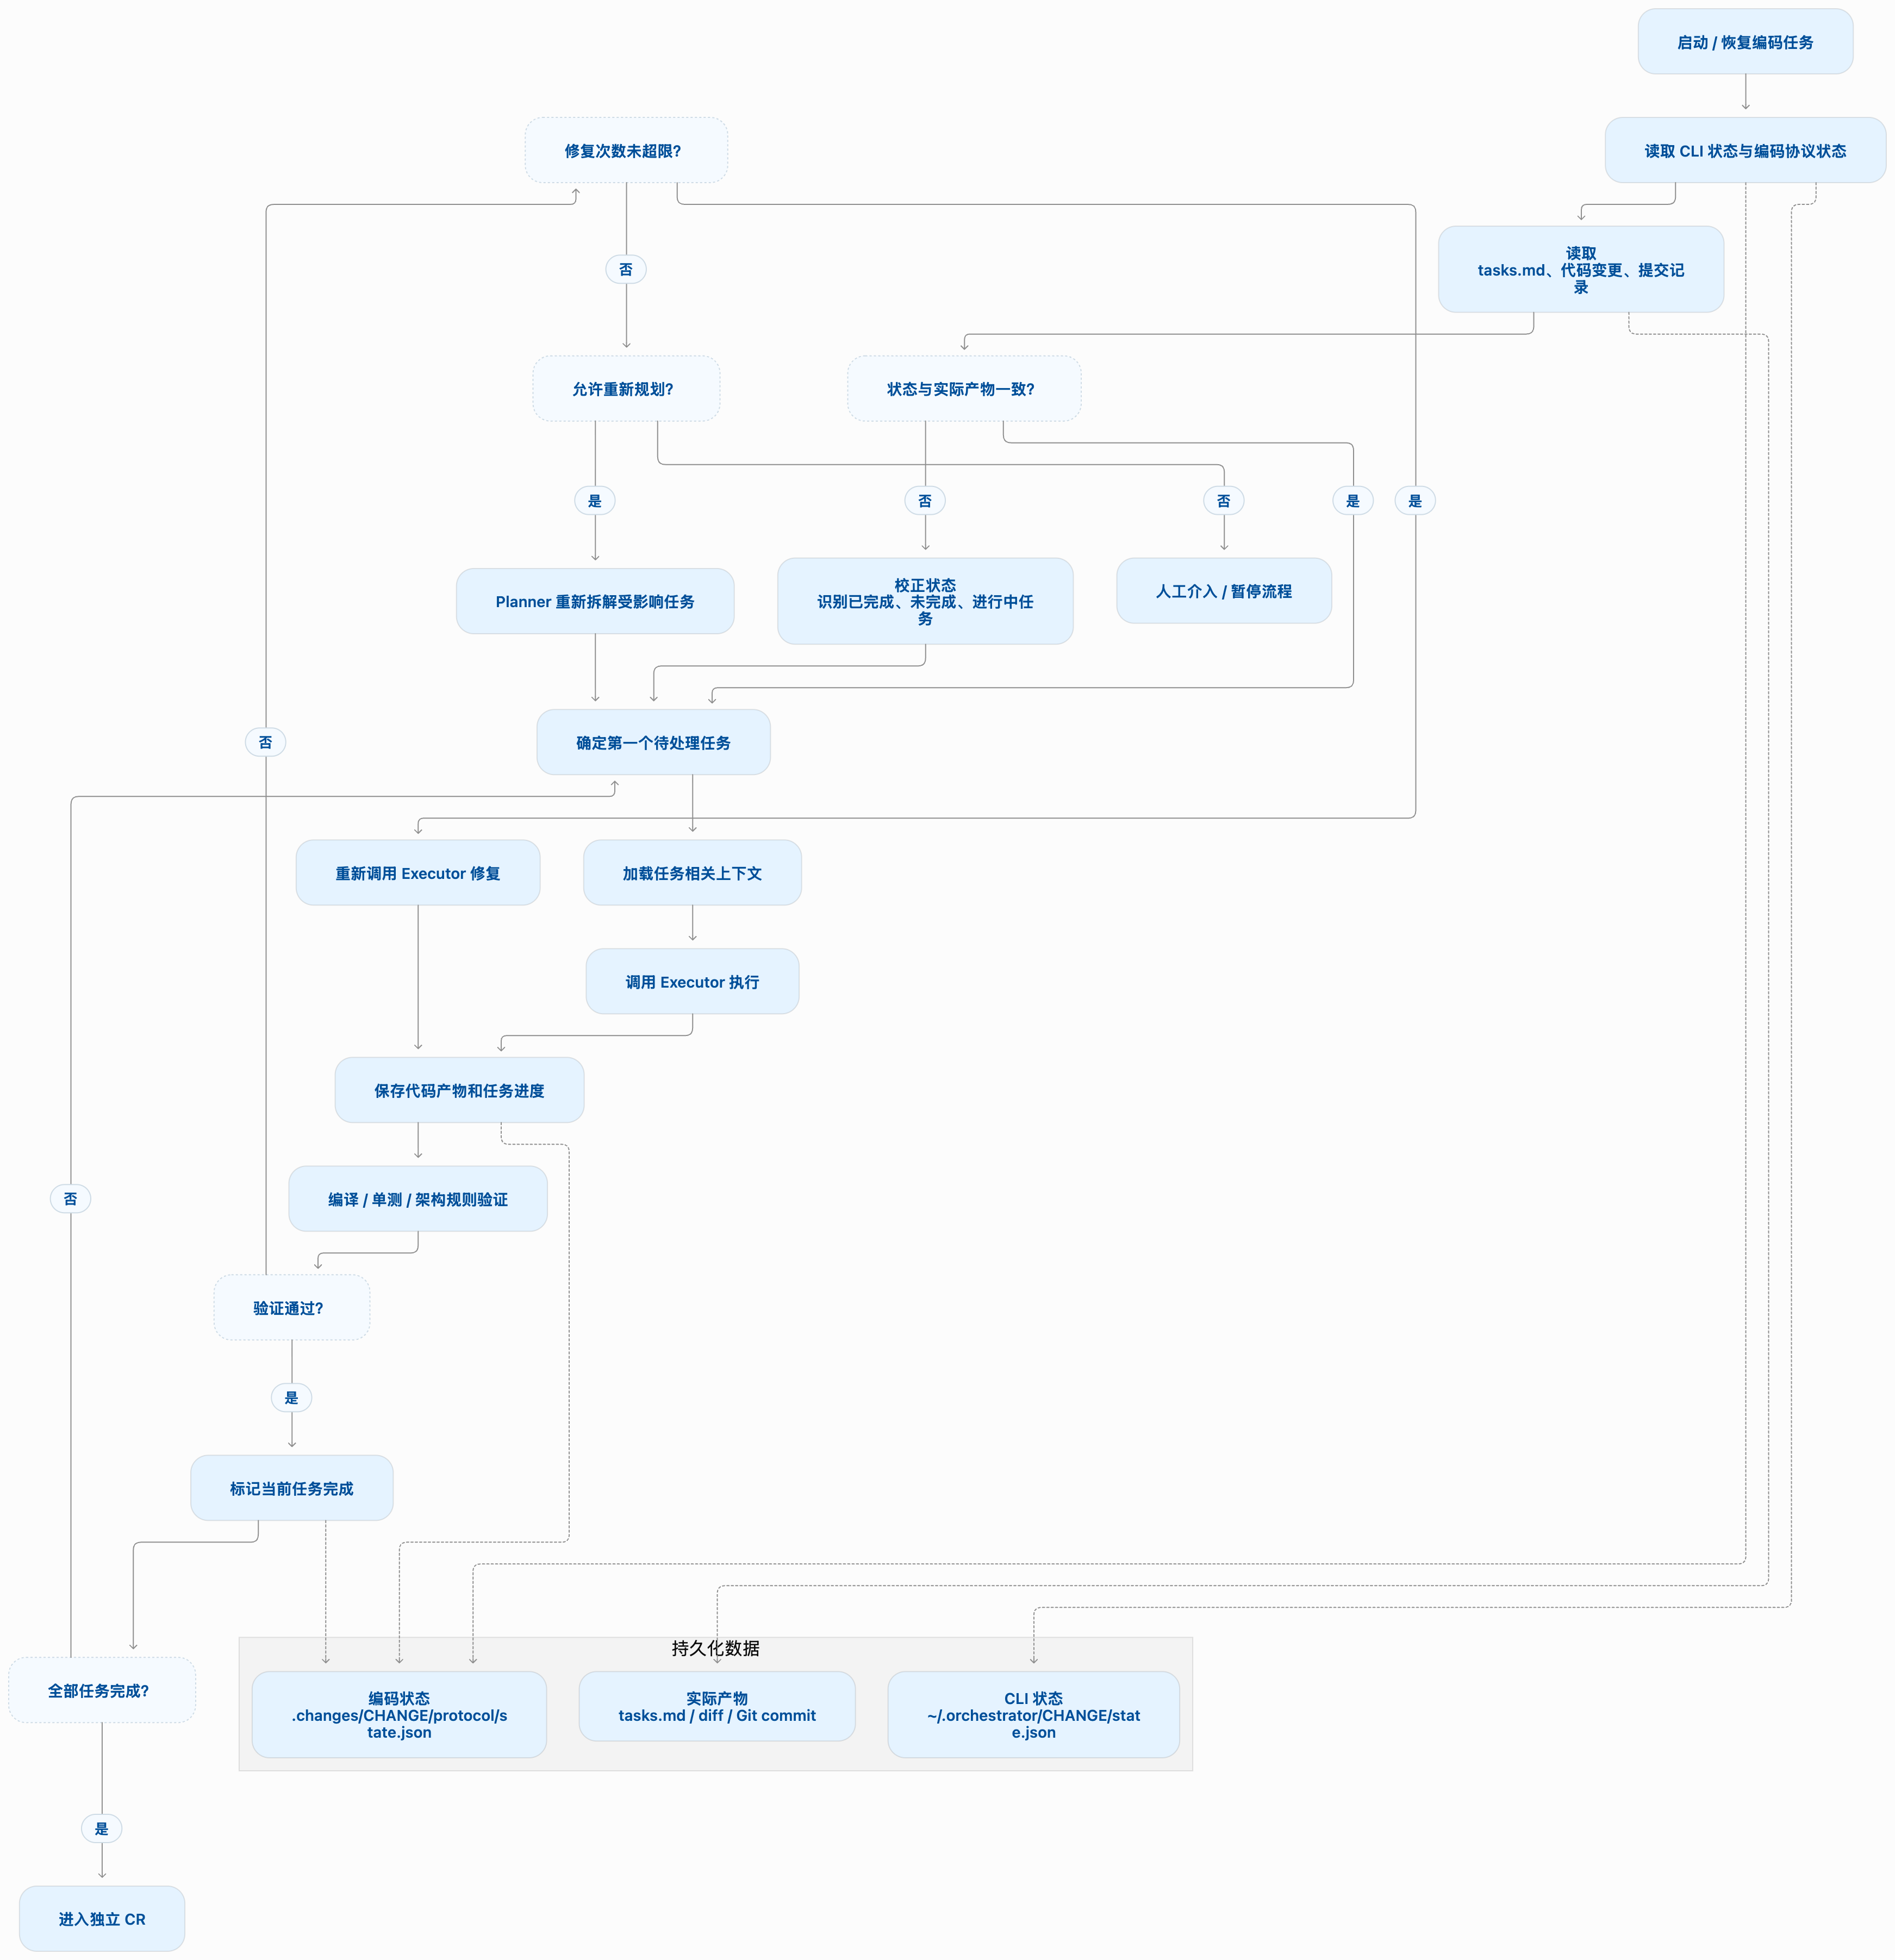
恢复流程:
- 读取三份状态:编码协议状态(
.changes/CHANGE/protocol/state.json)、实际产物(tasks.md/ diff / Git commit)、CLI 状态(~/.orchestrator/CHANGE/state.json); - 检查重试上限:修复次数未超限才继续,超限则判断是否允许重新规划——允许则 Planner 重新拆解受影响任务,不允许则人工介入;
- 校正状态:拿实际产物反查状态文件,识别已完成、未完成、进行中的任务——不信任状态文件的声明,以实际产物为准;
- 确定第一个待处理任务,加载任务相关上下文,调用 Executor 继续执行;
- 每个任务完成后保存产物和进度,跑编译/单测/架构规则验证,通过才标记完成,全部完成后进入独立 CR。
设计要点:状态恢复不是"读一个文件继续跑",而是用三份独立持久化的数据做交叉校验;所有重试有上限,超限就升级到人工——这保证了恢复后的执行仍然可控。
# 九、遥测:贯穿全程的旁路
遥测不是串行阶段,而是伴随整条流程运行的旁路。三条数据链路从执行现场汇聚到遥测后端,最后进入分析看板:
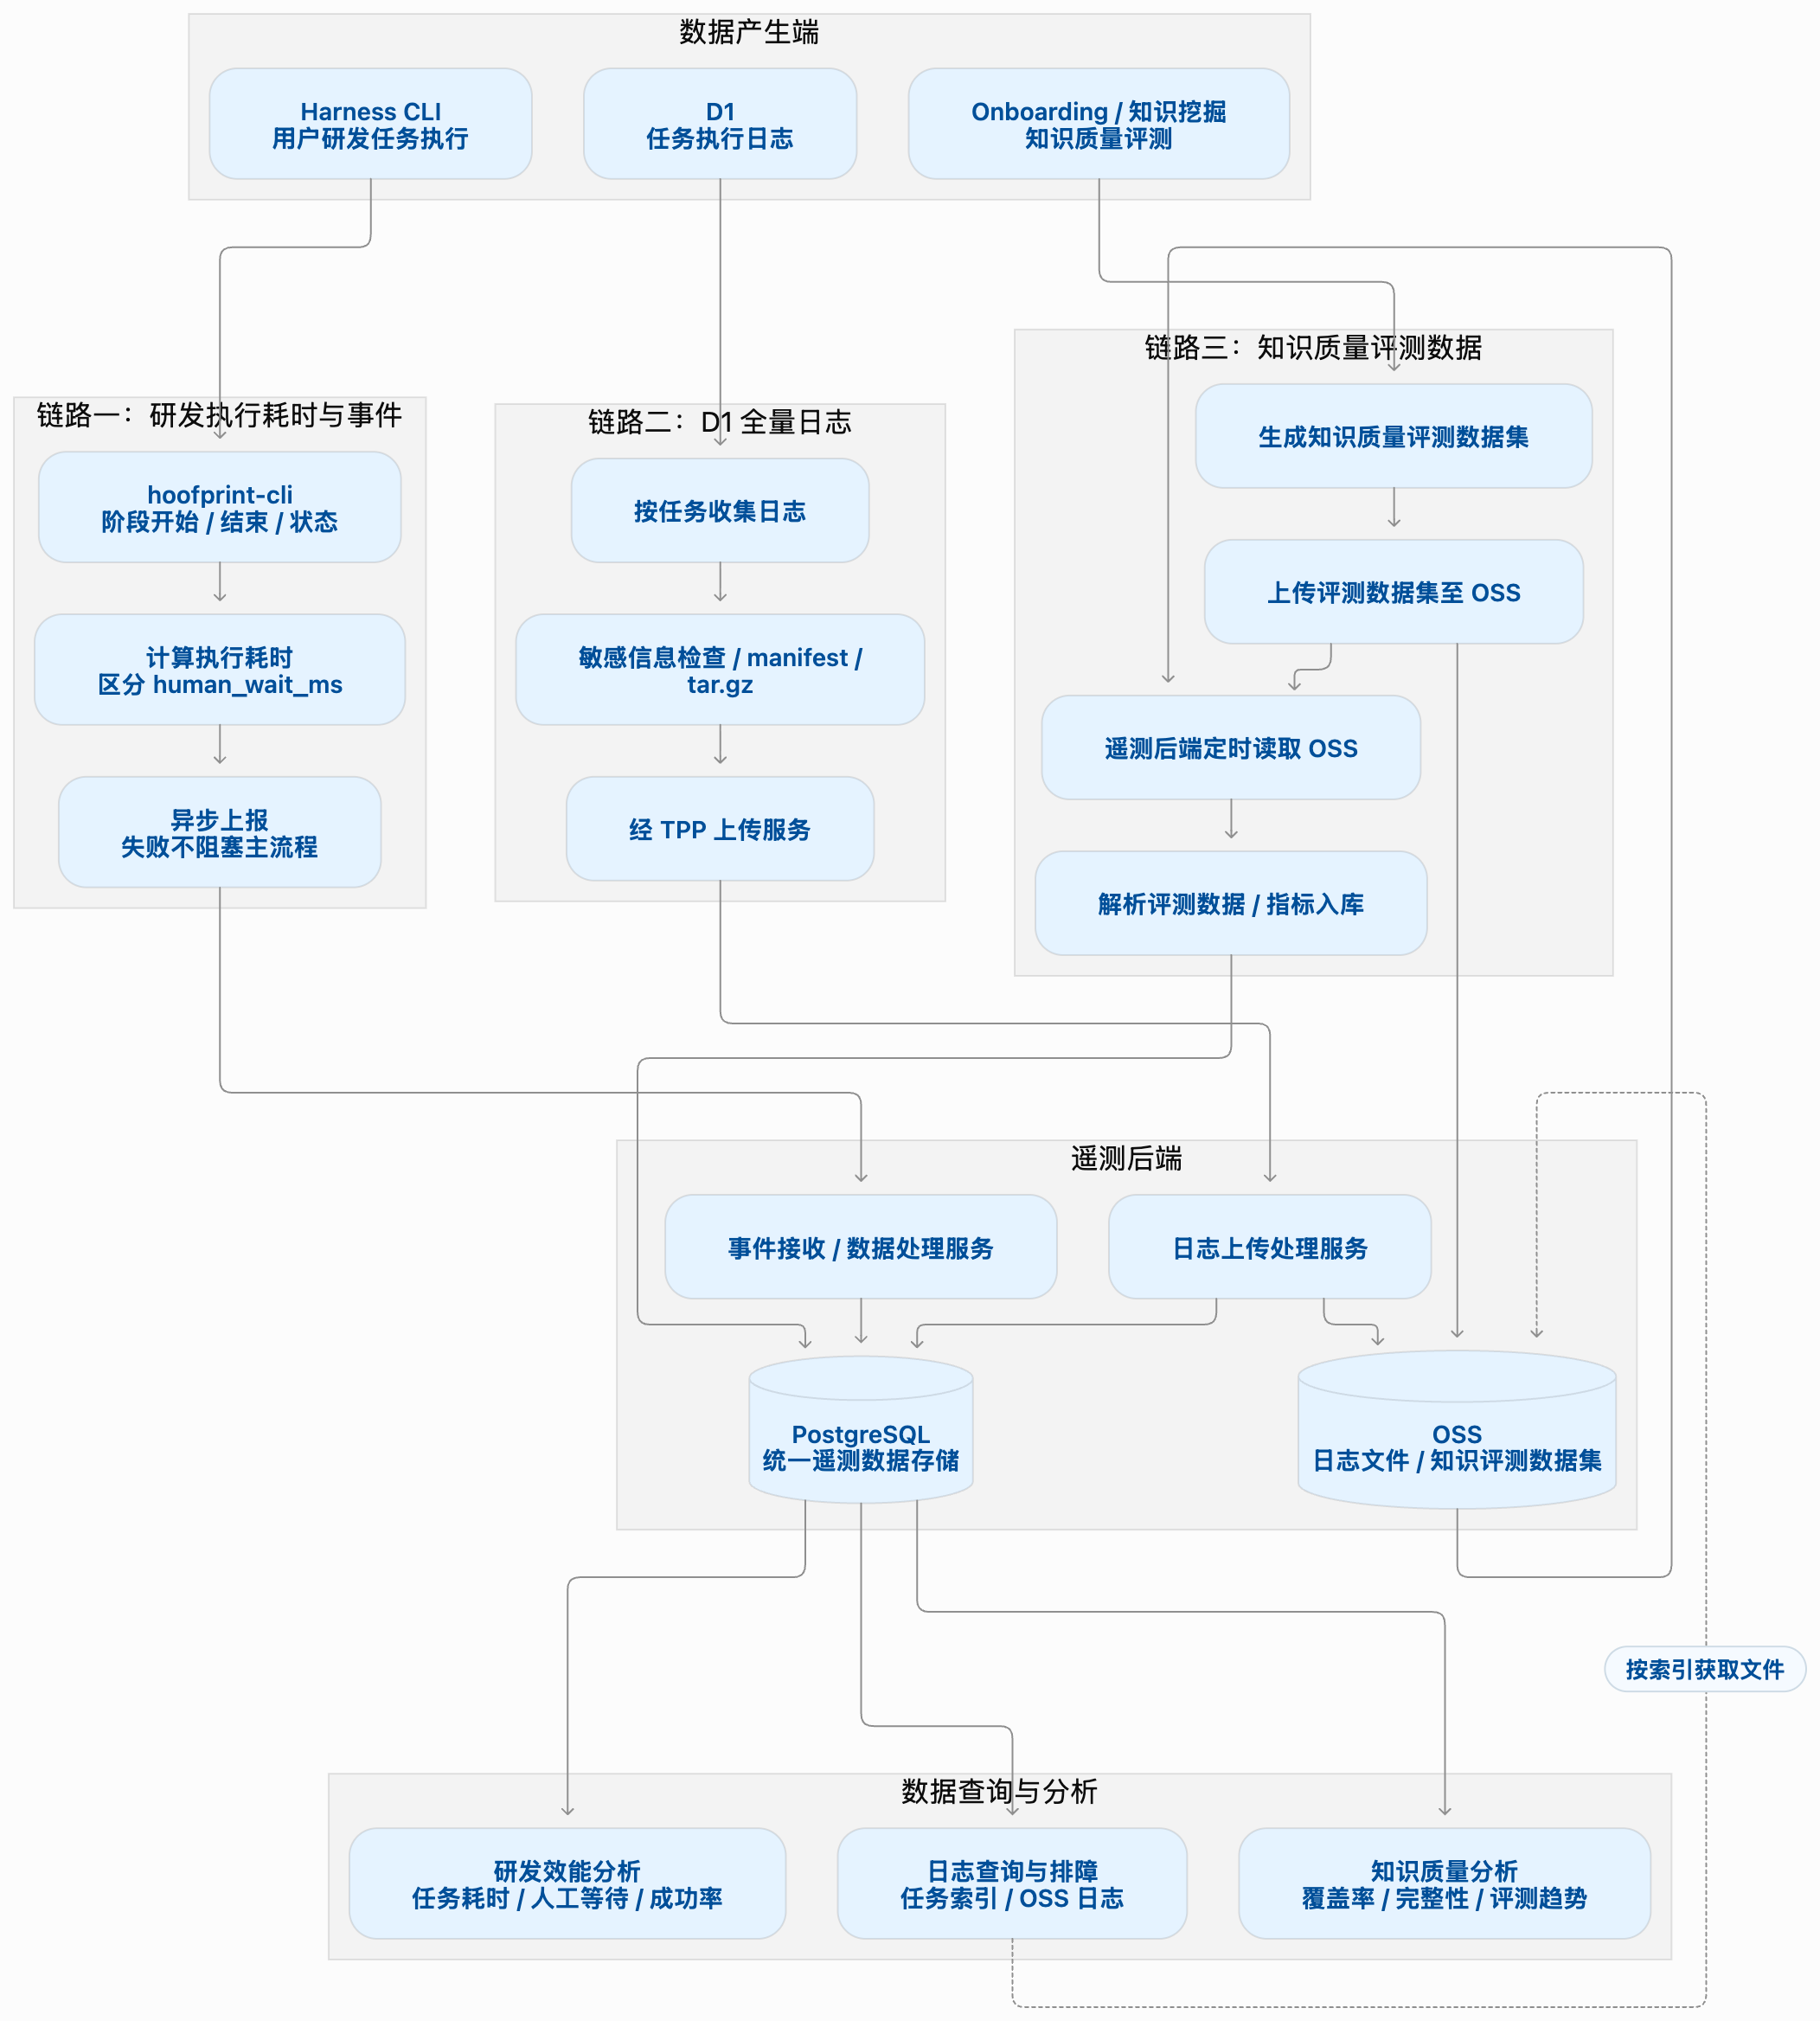
| 链路 | 数据内容 | 采集方式 |
|---|---|---|
| 链路一:研发执行耗时与事件 | 阶段开始/结束/状态 | hoofprint-cli 计算执行耗时、区分 human_wait_ms,异步上报 |
| 链路二:D1 全量日志 | 任务执行日志 | 按任务收集 → 敏感信息检查 → tar.gz 打包 → 经 TPP 上传服务 |
| 链路三:知识质量评测数据 | 知识质量评测数据集 | 生成数据集 → 上传 OSS → 遥测后端定时读取 → 解析指标入库 |
三条链路汇入遥测后端(事件接收/数据处理服务 + 日志上传处理服务),存储到 PostgreSQL(统一遥测数据)和 OSS(日志文件与评测数据集),支撑三类分析:
- 研发效能分析:任务耗时、人工等待、成功率;
- 日志查询与排障:任务索引、OSS 日志,按索引获取文件;
- 知识质量分析:覆盖率、完整性、评测趋势。
硬约束:遥测不能阻塞主流程。上报失败或超时(2 秒)就放弃,不影响编码。
# 十、知识沉淀:唯一大量写入的阶段
验收通过后,专门的沉淀阶段把本次执行的经验写回知识层。这是整条链路里唯一大量写入知识的阶段,前面所有环节都是读:
| 步骤 | 干什么 |
|---|---|
| 8.1 踩坑写入 | 本次需求中发现的问题和解决方式写进 AGENTS.md |
| 8.1.5 系分经验写候选层 | 系分阶段学到的知识进候选队列 |
| 8.2 需求经验沉淀 | 执行 trace 蒸馏成任务案例,再抽成候选知识 |
| 8.2.1 CR 反馈校准 | 方向错 → 系分盲区;细节漏 → 知识缺失;风格 → 只出建议 |
| 8.2.4 评分晋升 | 候选知识打分 ≥0.75 自动写入,0.50–0.75 转人工,<0.50 丢弃 |
| 8.2.5 重建索引 | 用脚本重建 catalog.md |
| 8.3 引用回写 | 更新每条知识的 last_referenced 时间,供衰减判断 |
这个阶段和第九节的遥测数据形成配合:遥测负责把执行过程记录下来,知识沉淀负责把值得保留的经验提炼出来并经过评分门槛入库——两者一起构成"越用越准"的记忆飞轮。
# 十一、整条流程串起来
项目 onboarding → 知识挖掘
       ↓
需求抓取 → 影响面分析 → 反问澄清 → 系分(最多3轮)
       ↓
拉分支 → 增量判定 → 记忆检索 → 拆任务 → 分批编码 → 补单测
       ↓
自动验证(编译+单测+架构规则)→ 独立CR → 漂移检查
       ↓
验收预检 → 集成测试 → 人工验收 → 提MR
       ↓
踩坑写入 → 经验沉淀 → 评分晋升 → 索引重建
       ↓
(遥测贯穿全程,最后汇入看板)
2
3
4
5
6
7
8
9
10
11
12
13
# 十二、一句话总结
我们把 AI 编码接进一套完整的研发流程。新项目先做 onboarding,生成项目说明和初始知识目录,让 AI 知道模块结构、编码规范和禁区;再通过知识挖掘,把业务规则、调用链、CR 经验和 commit 模式整理成结构化文件。需求进来后,AI 先分析影响范围、澄清问题,再出技术方案(最多 3 轮人工反馈);然后拆任务、分批写代码、补单测,经过编译、测试、架构规则和独立 CR 检查,最后人工验收并提 MR。执行过程中的日志和耗时会异步上报,用来分析真实 AI 耗时和流程瓶颈。我主要负责遥测链路和小需求快修路径。